Sistemas de recomendação baseados em aprendizagem por reforço para aplicações web: cenários de agregadores de rádios e de jogos
Introdução
Com o passar do tempo e a evolução contínua dos serviços de entretenimento digital, como o YouTube, a Netflix, o Spotify e as plataformas de jogos online, os sistemas de recomendação tornaram-se uma ferramenta diária essencial para os utilizadores. Estes sistemas poupam tempo aos utilizadores ao analisarem diversos conteúdos, facilitarem as pesquisas e sugerirem conteúdos relevantes de forma personalizada. No entanto, o mesmo nível de personalização não se encontra de forma consistente em todos os domínios de media, em particular nos setores do streaming de rádio e dos jogos
Os requisitos de escalabilidade e de melhoria constante tornam as abordagens de aprendizagem por reforço particularmente atrativas para cenários de aplicação de sistemas de recomendação.
O principal objetivo deste projeto foi desenvolver um sistema de recomendação inovador e eficiente, potenciado por aprendizagem por reforço, para duas aplicações distintas: um website agregador de jogos e um website agregador de rádios. Este sistema deveria ser capaz de fornecer sugestões personalizadas de jogos e de estações de rádio, adaptando-se às preferências e interesses dos utilizadores, bem como às alterações nos padrões de consumo ao longo do tempo.
Desenho de alto nível
Toda a aprendizagem por reforço tem pelo menos cinco elementos: um agente, um ambiente, um estado, uma recompensa e uma ação. O agente é o aprendiz ou decisor que interage com o ambiente, tomando continuamente decisões para alcançar o melhor resultado possível. O ambiente representa o contexto ou sistema externo com o qual o agente interage. Todos os dados recolhidos pelos “sensores” são captados e representados no estado, fornecendo ao agente a informação necessária para tomar decisões informadas e selecionar uma ação adequada. As ações são decisões tomadas pelo agente que influenciam o ambiente. Estas decisões são depois avaliadas, e a recompensa é o feedback recebido pelo agente após cada ação. A figura mostra o diagrama de componentes do sistema.
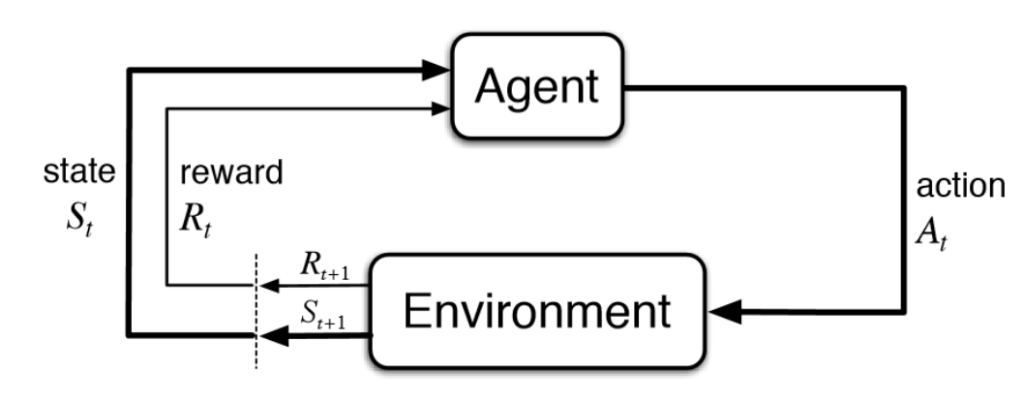
Diagrama de aprendizagem por reforço
O nosso sistema de recomendação foi desenvolvido para se integrar em plataformas web sem exigir demasiada preparação. O processo começa quando um utilizador acede à aplicação web e solicita uma página. Ao receber o pedido, o servidor web verifica se existe alguma recomendação em cache correspondente ao estado atual; se não for encontrada nenhuma, o sistema de recomendação gera uma nova lista de itens, que são depois obtidos e apresentados ao utilizador através da aplicação web. Cada interação do utilizador com os itens recomendados é captada através de um pedido POST enviado ao servidor, onde é guardada na base de dados para referência e análise futuras. Ao contrário dos RLRS convencionais, que normalmente fornecem recomendações imediatas em resposta a uma interação do utilizador, o nosso sistema introduz um atraso estratégico neste processo. Este atraso varia consoante o cenário de aplicação específico. Ao acumular mais interações dos utilizadores antes de gerar recomendações, o nosso sistema permite uma avaliação mais matizada e informada das preferências e comportamentos dos utilizadores em diferentes contextos. Esta abordagem facilita a produção de recomendações mais ajustadas, ponderadas e relevantes para as necessidades e interações reais do utilizador em vários cenários. Esta arquitetura permite uma integração transparente do sistema de recomendação na aplicação web, fornecendo aos utilizadores recomendações personalizadas com base nas suas interações e preferências anteriores. A utilização de uma base de dados para guardar as interações dos utilizadores e as recomendações permite a melhoria contínua do algoritmo de recomendação, resultando em recomendações mais precisas e relevantes ao longo do tempo.
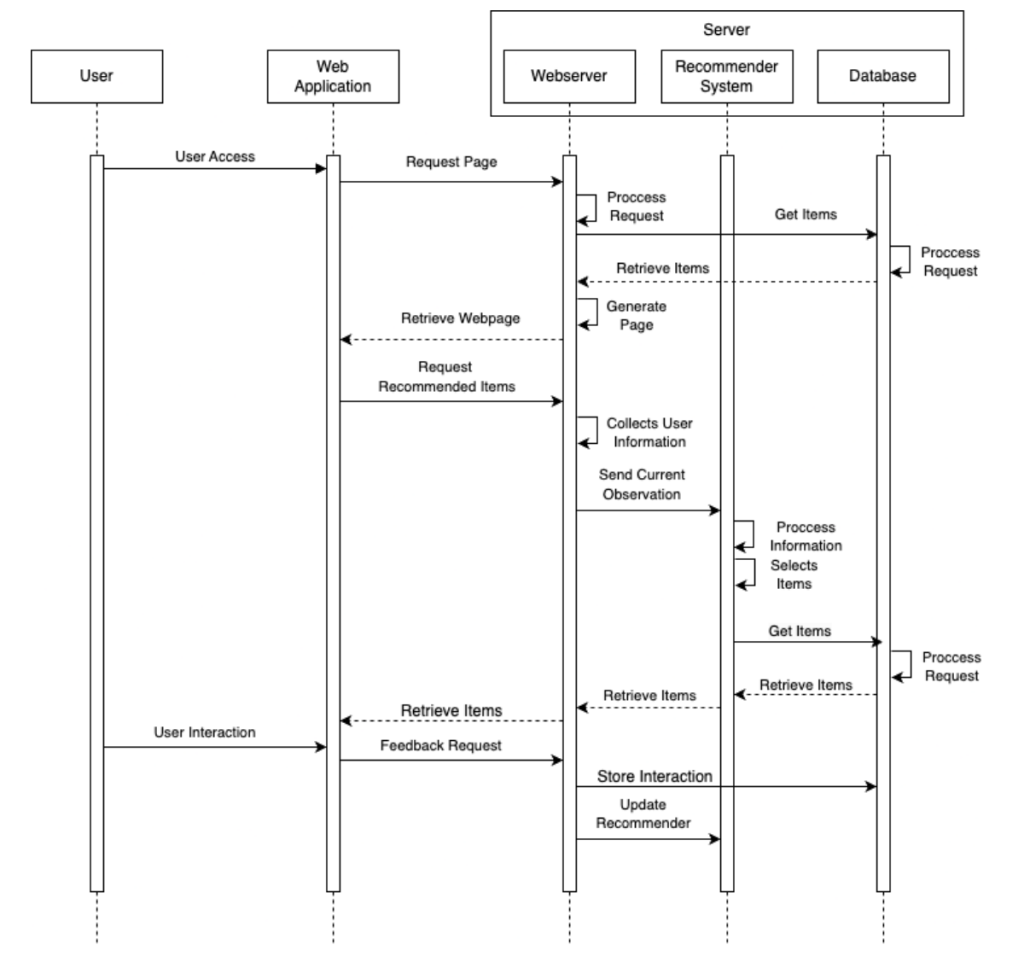
Diagrama de sequência do processo de recomendação
Desenho do software
Modelação da tarefa de recomendação: a tarefa de recomendação é modelada como um Processo de Decisão de Markov (MDP), em que um Agente Recomendador (RA) interage com o ambiente (utilizadores) ao longo de passos temporais sequenciais. O objetivo é maximizar as recompensas cumulativas através de recomendações estratégicas de itens que correspondam às preferências e ao histórico de navegação dos utilizadores.
Componentes do MDP:
- Espaço de estados S: um estado st = {s1t, s2t, …, snt} é definido como o histórico de interações de um utilizador, i.e., os N itens anteriores que um utilizador consultou antes do instante t. Os itens em st estão ordenados cronologicamente.
- Espaço de ações A: uma ação at = {a1t, a2t, …, ant} consiste em recomendar uma lista de itens a um utilizador no instante t com base no estado atual st, em que K é o número de itens que o RA recomenda ao utilizador de cada vez.
- Recompensa R: depois de o agente recomendador executar uma ação at no estado st, i.e., recomendar uma lista de itens a um utilizador, o utilizador consulta esses itens e fornece o seu feedback. Pode então ignorar (não clicar), clicar ou reproduzir esses itens, e o agente recebe uma recompensa imediata r(st, at) de acordo com o feedback do utilizador.
- Probabilidade de transição P: a probabilidade de transição p(st+1|st,at) define a probabilidade de transição de estado de st para st+1 quando o RA executa a ação at. Assumimos que o MDP satisfaz p(st+1|st,at,…,s1,a1) = p(st+1|st,at). Se o utilizador ignorar todos os itens recomendados, então o estado seguinte é st+1 = st; se o utilizador clicar/encomendar parte dos itens, então o estado seguinte st+1 é atualizado.
- Fator de desconto [0,1]: define o fator de desconto na medição do valor presente da recompensa futura. Em particular, quando gamma = 0, o RA considera apenas a recompensa imediata. Quando gamma = 1, todas as recompensas futuras podem ser contabilizadas integralmente na recompensa da ação atual.
Extração e seleção de características
Nos sistemas de recomendação, utilizar apenas identificadores discretos dos itens é insuficiente para modelar as relações e propriedades dos itens. Uma alternativa é construir embeddings dos itens utilizando informação auxiliar, como atributos, texto ou interações históricas. Neste trabalho, adotámos uma abordagem que explora o histórico de interações utilizador-item para gerar embeddings.
A metodologia trata os itens de forma análoga às palavras, sendo o histórico sequencial de interações de um utilizador equiparado a uma frase textual. Assim, as ligações semânticas latentes entre itens podem ser extraídas aplicando técnicas de word embedding ao corpus de sessões históricas.
Concretamente, utilizámos um pipeline que constrói características como a popularidade, codifica metadados categóricos através de one-hot encoding e extrai vetores semânticos do texto dos títulos através de TF-IDF e SVD. O resultado concatenado é um embedding de item rico, que integra metadados, texto e sinais colaborativos. A redução de dimensionalidade melhora a eficiência das tarefas subsequentes. Esta abordagem de aprendizagem de representações induz embeddings que captam não só atributos, mas também relações latentes entre itens que emergem dos padrões de utilização da comunidade.
Desta forma, vamos além de simples índices, passando para um espaço vetorial semântico aprendido que capta ligações subtis entre itens. A nossa técnica baseada na utilização fornece um sinal de aprendizagem complementar aos atributos ou descrições. Os embeddings resultantes podem complementar as abordagens de recomendação existentes, fornecendo características úteis para melhor discernir e recomendar itens relevantes.
Arranque a frio (cold start)
O problema do arranque a frio (cold start) é um desafio significativo nos algoritmos de recomendação. Podem ser identificados três tipos distintos de cenários de arranque a frio
- Novos utilizadores (a): o algoritmo não dispõe de dados históricos ou de preferências para fazer recomendações precisas a novos utilizadores.
- Novos itens (b): o sistema não dispõe de interações ou feedback suficientes dos utilizadores para avaliar com precisão a relevância de novos itens.
- Utilizadores e itens novos (c): esta é a situação mais complexa. O algoritmo enfrenta um duplo desafio, pois tem de lidar com a ausência de dados históricos tanto dos utilizadores como dos itens, o que complica o processo de recomendação.
Para enfrentar o problema do arranque a frio, propõe-se uma abordagem multifacetada. No caso das recomendações para novos utilizadores, recomendamos itens com base na sua popularidade entre os utilizadores existentes, tirando partido das tendências atuais no sistema. Quanto aos novos itens, concebemos embeddings de itens que utilizam os metadados dos itens, como descrições, categorias e subcategorias. Tirando partido destes embeddings baseados em metadados, conseguimos estabelecer ligações entre itens adicionados recentemente e itens já existentes, facilitando recomendações mais informadas. Esta abordagem permite ao sistema fazer inferências inteligentes e mitigar o impacto do problema do arranque a frio nos algoritmos de recomendação.
Desenho da recompensa
No cerne da aprendizagem por reforço está o conceito de recompensa, que fornece uma medida numérica da qualidade ou conveniência da ação de um agente num determinado estado. O objetivo do agente é aprender uma política que maximize a recompensa cumulativa esperada ao longo das interações. Assim, o desenho do sistema de recompensas tem uma grande influência no comportamento do agente e no seu direcionamento para os resultados pretendidos.
Objetivo
A função de recompensa foi cuidadosamente concebida para abranger várias facetas das interações e do envolvimento dos utilizadores, diretamente ligadas à eficácia das recomendações. A função de recompensa é constituída por duas componentes fundamentais:
Componentes da recompensa
Distribuição de cliques (CD): esta componente mede a distribuição dos cliques dos utilizadores pelo conjunto de itens recomendados. Desempenha um papel vital na garantia da diversidade e do equilíbrio do conteúdo recomendado. Uma distribuição de cliques mais uniforme significa que os utilizadores consideram apelativo e interessante um leque mais amplo de recomendações, aumentando a utilidade e a atratividade globais do sistema de recomendação. Este aspeto é particularmente crucial para garantir a satisfação dos utilizadores, aumentando assim a probabilidade de regresso.
Tempo de permanência (DT): é uma medida do tempo que os utilizadores passam a interagir com um item recomendado. Um tempo de permanência mais longo indica que o utilizador considera o conteúdo recomendado interessante e cativante, o que é um resultado positivo do ponto de vista da qualidade da recomendação. No contexto de aplicações web dependentes de receitas publicitárias, um tempo de permanência mais longo aumenta a probabilidade de os utilizadores visualizarem e interagirem com mais anúncios, aumentando assim a potencial receita publicitária.
Formulação da recompensa
Dadas estas componentes cruciais, a função de recompensa ( R(s,a) ) para um estado ( s ) e uma ação ( a ) é estrategicamente construída da seguinte forma:
R(s,a) = w_1 * DT + w_2 * CD
Nesta formulação, ( w_1 ) e ( w_2 ) são pesos atribuídos para calibrar a importância de cada componente na função de recompensa. O desenho cuidadoso desta função de recompensa permite uma boa avaliação do desempenho do sistema de recomendação, garantindo que este não é apenas teoricamente sólido, mas também alinhado, na prática, com objetivos de negócio do mundo real.
Tendo em conta o sistema de recomendação descrito anteriormente, é crucial ilustrar a sua aplicação em diferentes áreas – uma delas um agregador de jogos e a outra um agregador de rádios. Ambas as áreas, embora distintas na sua oferta, proporcionam uma perspetiva única sobre a funcionalidade e a adaptabilidade do nosso algoritmo. Consequentemente, isto ajudar-nos-á a compreender a versatilidade do sistema e a sua capacidade de gerar recomendações significativas em domínios díspares.
Resultados
O sistema foi testado em dois domínios do mundo real, um agregador de jogos e um agregador de rádios.
Listas de rádios com melhoria automática
Dados recolhidos para avaliação
Como referido anteriormente, o nosso sistema foi testado num contexto real de aplicação em produção, com utilizadores reais. Para iniciar este processo, preparámos o nosso algoritmo com dados acumulados ao longo dos três meses anteriores. Após esta fase preparatória, implementámos o sistema no website regional da Colômbia. Durante os dois meses seguintes, o algoritmo funcionou neste ambiente em produção, recolhendo e processando autonomamente dados de interação dos utilizadores. A nossa avaliação, tal como detalhada neste capítulo, centra-se na análise dos resultados e conclusões obtidos durante este período de funcionamento de dois meses, no qual o nosso algoritmo produziu 60 listas.
Análise dos resultados do algoritmo
Para avaliar eficazmente a evolução e o desempenho do nosso algoritmo, utilizaremos duas métricas fundamentais. A primeira, a recompensa cumulativa, dá uma ideia dos benefícios totais que o algoritmo acumula ao longo do tempo. A segunda métrica, o arrependimento (regret), fornece uma perspetiva comparativa, evidenciando a diferença entre os resultados alcançados pelo nosso algoritmo e os resultados ótimos possíveis.
| Primeiro mês | Segundo mês | |
| Recompensa média | 20 | 30 |
| Arrependimento médio | 80 | 70 |
Cobertura
No caso específico em estudo, a cobertura é avaliada com base na seleção de estações de rádio na Colômbia. Durante um período de dois meses, o sistema apresentou consistentemente um valor de cobertura de aproximadamente 25%. Este valor foi determinado pela seleção de 92 rádios de um total possível de 367, ilustrando a capacidade do sistema para aceder a uma gama diversificada de opções de rádio e utilizá-la.
O conceito de cobertura neste estudo é crucial, pois reflete a capacidade do sistema para recomendar um amplo espetro de rádios, garantindo que os utilizadores dispõem de opções variadas.
Popularidade
As tendências de popularidade são um pilar para compreender a robustez e a adaptabilidade do nosso algoritmo de recomendação no domínio da radiodifusão.
A partir dos dados ilustrados na figura abaixo, e corroborados pelo conjunto de dados fornecido, identificámos padrões dignos de nota em dois intervalos distintos: junho-julho e julho-agosto. Os dados mostram uma tendência clara de o algoritmo favorecer um conjunto específico de rádios que parecem ser mais relevantes para os ouvintes ao longo do tempo.
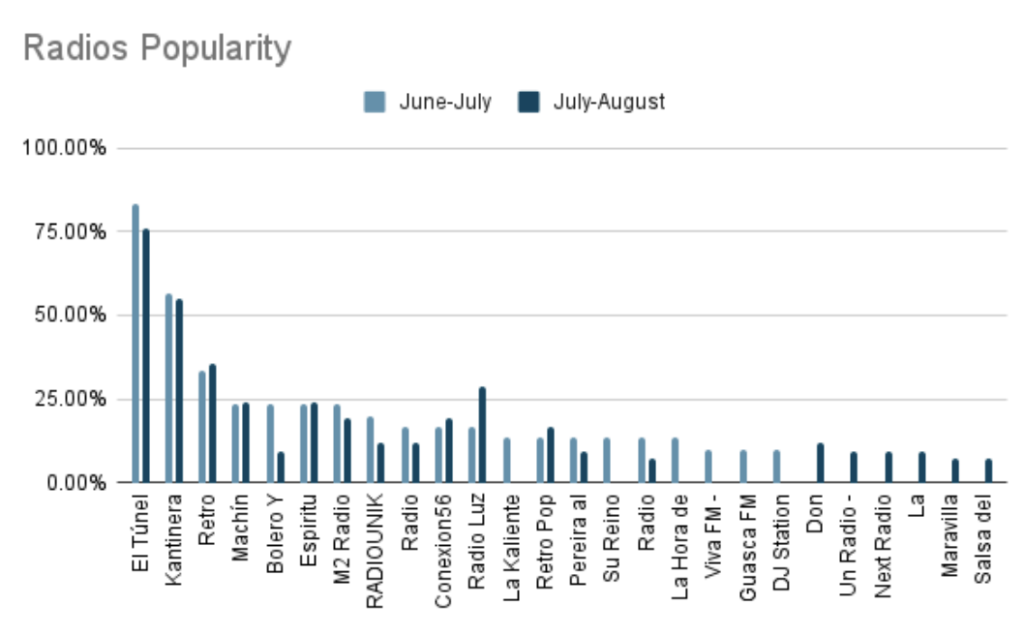
Gráfico de popularidade das rádios
Avaliação das métricas online
A figura abaixo apresenta uma representação visual da evolução do nosso sistema no mercado colombiano de 21 de junho a 21 de agosto. Observando com atenção, verifica-se uma tendência geral de subida, que evidencia um alinhamento crescente entre as preferências dos utilizadores e as nossas recomendações. No entanto, também se destaca uma descida digna de nota entre as semanas 29 e 31. Estes desvios ocasionais podem ser atribuídos à natureza exploratória dos algoritmos de aprendizagem por reforço, que por vezes tomam ações aparentemente subótimas, mas essenciais para uma aprendizagem mais ampla e de longo prazo.
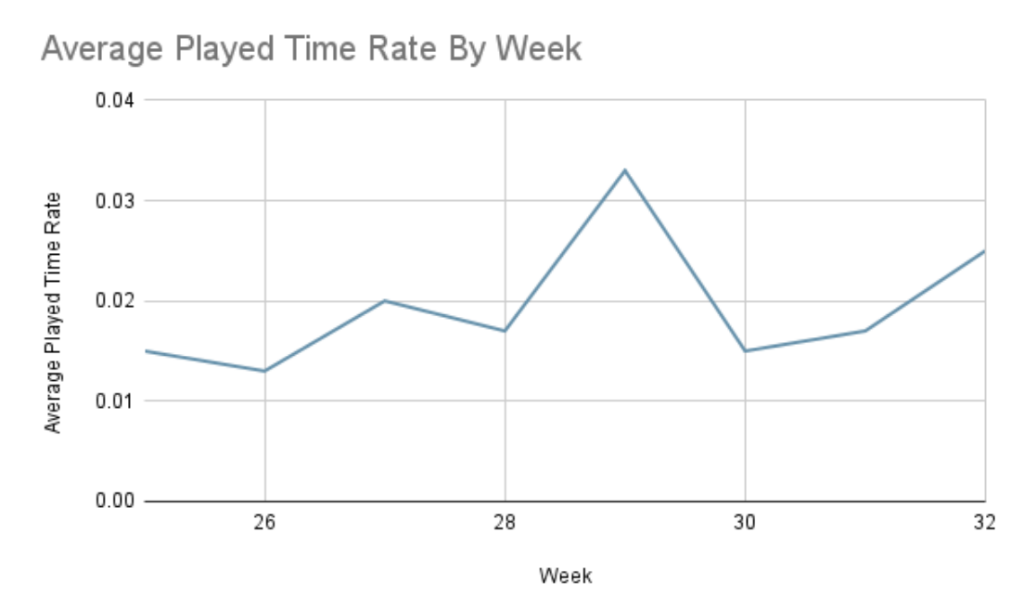
Gráfico da taxa média de tempo de reprodução por semana
Aprofundando os desvios observados entre as semanas 29 e 31, a figura abaixo chama a atenção para um padrão intrigante. Esta figura evidencia a correlação entre as rádios que não conseguiram ser reproduzidas e a descida das nossas métricas de desempenho. Concretamente, nas semanas 30 e 31, uma média preocupante de 2,9 das 6 rádios não foi reproduzida. Embora isto possa parecer mínimo isoladamente, quando comparado com a média de 2,1 das outras semanas, a diferença torna-se significativa. Dado que as nossas listas contêm seis itens e, em média, metade deles não é reproduzida devido a erros, esta limitação torna-se evidente e exige atenção imediata.
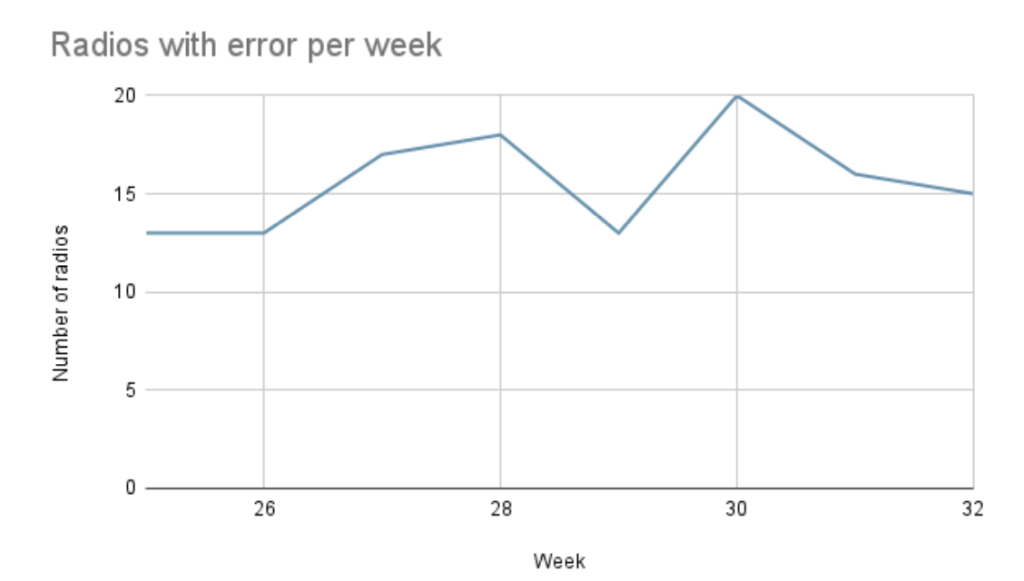
Gráfico do número médio de rádios com erro por semana
Sistema de recomendação de jogos
No nosso processo de avaliação, recolhemos dados do Reludi, a nossa aplicação web agregadora de jogos.
Dados recolhidos para avaliação
O conjunto de dados continha métricas cronológicas de interação dos utilizadores, como cliques e tempo de jogo, acumuladas ao longo de aproximadamente um mês. Estes dados amostrados foram depois utilizados no treino inicial do nosso sistema de recomendação, permitindo ao modelo tirar partido de informações e padrões valiosos das interações dos utilizadores. Começámos por ordenar os dados cronologicamente e depois dividimo-los em duas partes: treino e teste. Para isso, utilizámos as três primeiras semanas de dados recolhidos para treino e reservámos a semana restante para teste. Esta organização sistemática dos dados foi crucial para preservar a integridade sequencial das interações dos utilizadores, facilitando a extração de informação temporal significativa. Após a avaliação offline, o modelo pré-treinado foi implementado num ambiente de produção real. Na transição para um contexto online, o modelo utilizou o conhecimento adquirido no treino offline para se adaptar às interações e ao feedback reais dos utilizadores. Esta fase decorreu durante um período de seis meses. Esta abordagem ponderada e a implementação estruturada do modelo num ambiente dinâmico permitiram um ajuste e uma otimização apurados, melhorando o seu desempenho e as suas capacidades de recomendação com base no envolvimento e nos comportamentos reais dos utilizadores.
Análise dos resultados do algoritmo
Uma vez que a estrutura base do nosso sistema se mantém inalterada, é essencial utilizar as mesmas medidas de avaliação descritas anteriormente. Analisando a tabela abaixo, é claro que o contexto offline proporciona uma recompensa média superior e um arrependimento médio inferior em comparação com o contexto online. No ambiente offline, o algoritmo apresenta um desempenho satisfatório, evidente pelas recompensas e arrependimentos médios.
| Primeiro mês | Segundo mês | |
| Recompensa média | 40 | 20 |
| Arrependimento médio | 60 | 80 |
Cobertura
Durante um período de seis meses, foram periodicamente introduzidos jogos no sistema pela equipa de conteúdos, uma dinâmica à qual o sistema teve de se adaptar e que teve de gerir de forma eficiente. Apesar da variação do conjunto de jogos, o sistema revelou uma notável capacidade de adaptação, mantendo uma métrica de cobertura de aproximadamente 53,15%, ao recomendar 430 jogos de um conjunto em evolução que chegou a atingir 809 jogos.
Popularidade
O gráfico abaixo foi criado com os nossos dados de produção; no eixo y podemos ver a percentagem do número de vezes que um jogo foi recomendado, tendo em conta o número de recomendações, e no eixo x podemos ver o nome do jogo.
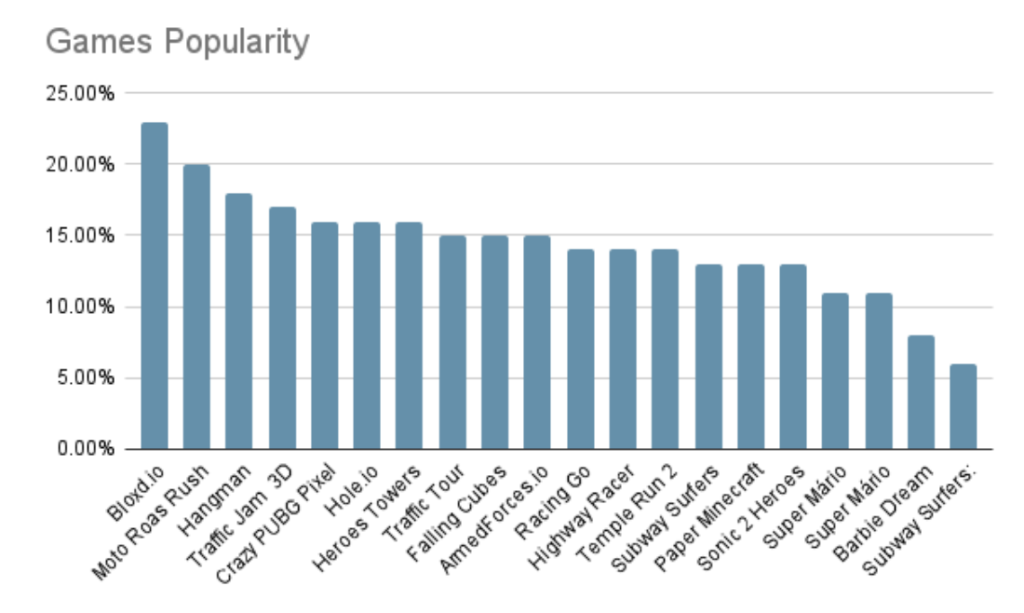
Gráfico de popularidade dos jogos
Avaliação das métricas online
Na figura abaixo, é apresentada uma trajetória evolutiva abrangente do nosso sistema de recomendação através das interações dos utilizadores. A visualização mostra duas métricas essenciais: a duração total em segundos e o total de cliques, representados no eixo y, enquanto o eixo x apresenta o número de interações. Na ilustração, as linhas individuais representam utilizadores únicos, enquanto uma linha vermelha mais destacada assinala o utilizador médio em ambos os gráficos, estabelecendo uma referência comparativa entre as métricas avaliadas.
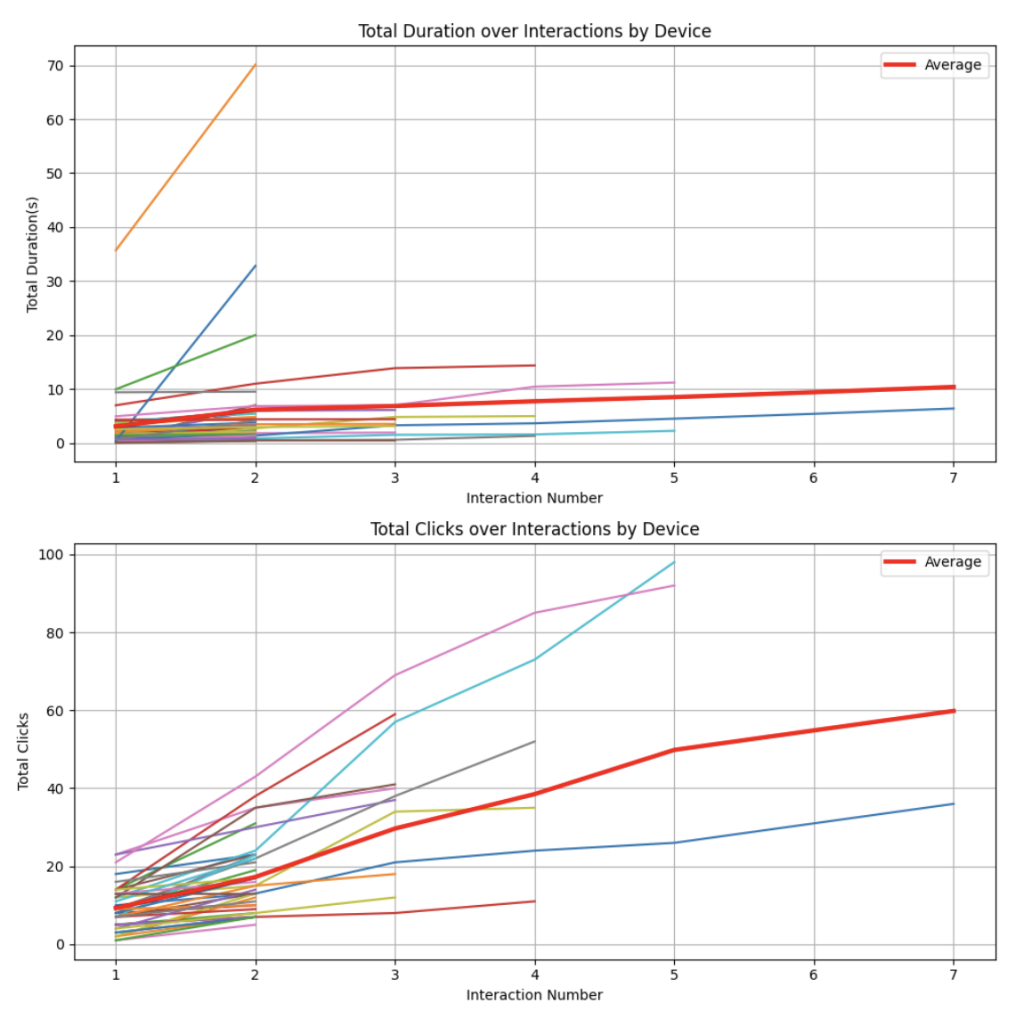
Gráfico da avaliação online dos jogos
Interface web
As figuras abaixo mostram a interface web dos nossos dois cenários, o agregador web (Reludi) e o agregador de rádios (MyTunner)
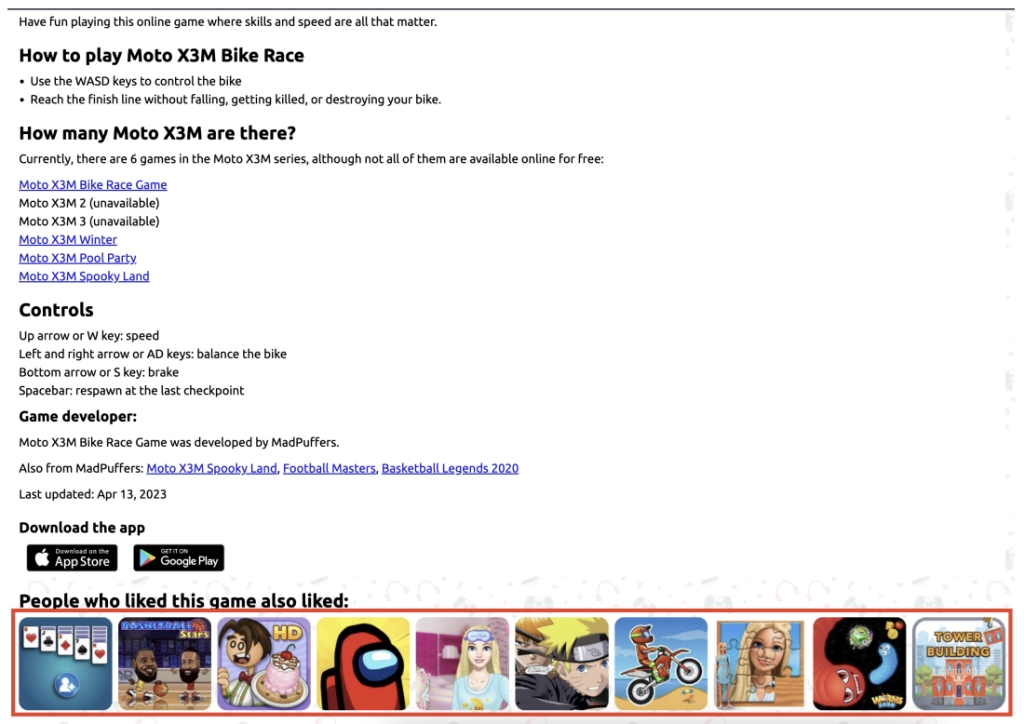
Interface web do sistema de recomendação Reludi
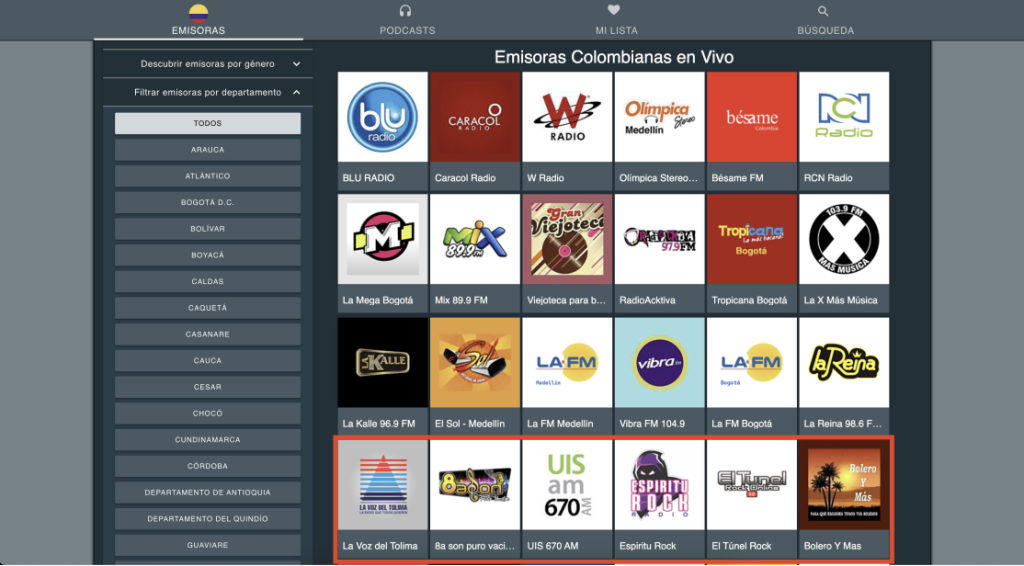
Interface web do sistema de recomendação Mytunner
Conclusão
No decurso deste trabalho, foi concebido e implementado com sucesso um sistema de recomendação, com base no algoritmo DDPG e na sua metodologia. Este sistema integra-se de forma transparente em duas aplicações distintas: uma plataforma de agregação de jogos e uma plataforma de agregação de estações de rádio. Ajusta habilmente as sugestões de jogos e de estações de rádio, adaptando-se às preferências dos utilizadores e à evolução dos padrões de consumo. A interface do sistema de recomendação não só é visualmente apelativa e fácil de utilizar, como se harmoniza perfeitamente com a linha de design existente de ambas as plataformas. Esta fusão estratégica atenua a desorientação dos utilizadores, promovendo um ambiente de interação unificado. Como resultado, o sistema funciona eficazmente, aumentando de forma significativa o envolvimento dos utilizadores, um objetivo fundamental da nossa investigação. Ainda assim, surgiram alguns desafios durante a implementação. O tratamento de um volume substancial de dados de pré-teste poderá aumentar o tempo de processamento à medida que as bases de dados de itens crescem. Apesar deste desafio, o nosso objetivo principal de demonstrar a viabilidade prática e a utilidade de um sistema de recomendação baseado em RL foi alcançado de forma satisfatória. Os resultados da análise revelaram uma melhoria acentuada da proficiência do sistema, que se adaptou habilmente à variação dos padrões de consumo dos utilizadores. As recomendações fornecidas foram diversificadas e relevantes. Em suma, este projeto evidencia o potencial do sistema de recomendação desenvolvido para fornecer recomendações precisas e personalizadas aos utilizadores. Além disso, as recomendações do sistema demonstram capacidade de evolução temporal, sincronizando-se com as preferências dos utilizadores para enriquecer de forma abrangente a sua experiência de utilização.